「このマージボタン、押していいやつ?」——AIエージェントにコードを書かせて PR まで作らせたあと、最後にこの一瞬で固まった経験はないでしょうか。ここまでは案外あっさり動きます。手が止まるのはその次で、出てきた PR をそのままマージしてよいのか、それとも毎回すべて人間が目を通すのか。全部自動にすれば楽ですが、ごくたまに紛れ込む危険な変更が怖い。かといって全部人間がレビューするなら自動化した意味が半分くらい消えます(そのために組んだパイプラインでは?)。「AIの出力、どこまで信用していいの?」に結局戻ってきます。
現実的な落としどころは「ほとんど通す、危険だけ人間が止める」の中間です。この記事では、AIが生成した変更を自動〜半自動でマージするパイプラインに置く「門番」の設計を書きます。テーマはマージ権限をどう配るか、つまり自動マージのガバナンスです。
なお、これはコマンドの実行時に事故を止める話ではありません。以前書いたエージェントの本番実行で起こるセキュリティ事故を hooks で防ぐは、実行の瞬間に危険操作をブロックする下流の防御でした。今回はもう一段上流、「この変更をマージ対象として信用してよいか」を判断する門の話で、守る場所が違います。
この記事で扱うこと
- 危険な変更だけを検出し、そこだけ一回限りの承認(one-shot clearance)で人間の判断を挟む設計
- ブランチ名のような LLM 経由の入力を、完全一致 + allowlist で検証する考え方
- worktree への依存インストールを lockfile のあるときだけに限定する判断
- breaking 変更の検出を、LLM の自由文出力ではなく構造化フィールドと issue 本文に限定した話
全体を貫く原則は一つだけです。判定は決定論的な関数で行い、LLM の出力は検証してから使う。 AIの提案は入力として扱い、合否そのものはコードで決める線引きです。
門番の全体像
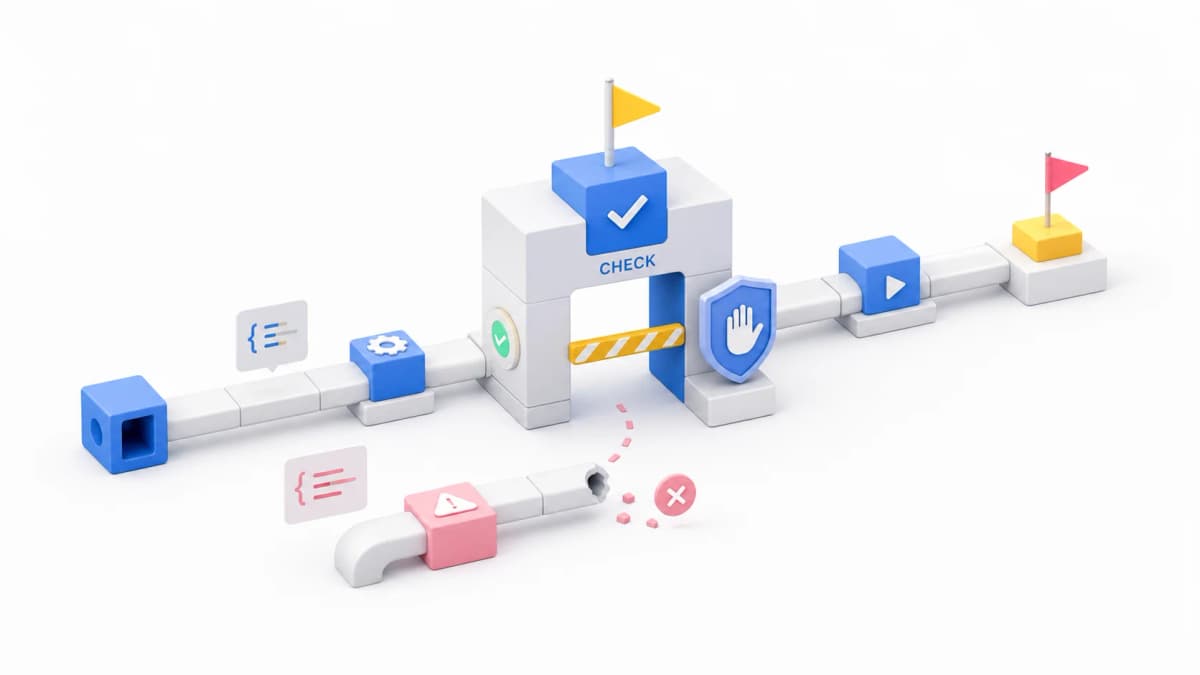
流れを俯瞰します。エージェントが実装を終えたあと、マージまでに複数のチェックが直列に並びます。
ポイントは、分岐の条件(危険かどうか、breaking かどうか)を LLM の気分で決めていないことです。どの分岐も、決まった入力を受け取って真偽を返す小さな関数が担当します。門番を構成する4つの判断を順に見ていきます。
1. 危険な変更だけ止める:一回限りの承認
自動マージで一番こわいのは、権限周りやデータ削除のような「うっかり通したら取り返しがつかない」変更です。これを機械的に拾うため、変更差分に対して危険パターンの検出(danger-grep と呼んでいます)を走らせます。7つほどの危険クラス——権限昇格、削除系、認証情報の取り扱いなど——を常に監視対象として持ち、差分がどれかに触れたら「未確認」の印を立てます。
問題は印が立った変更をどう扱うかです。安直にやると二つの失敗に落ちます。一つは全部人間に投げること(自動化前のレビュー負荷がそっくり戻ります)。もう一つは「一度 OK を出したパターンは以後ずっと素通り」の恒久 allowlist にすることです。後者は楽ですが、文脈が変われば危険度は変わるので素通りの穴が固定されます。
採用したのは、その中間にあたる一回限りの承認(one-shot clearance)です。あるパイプラインでは、マージ層で危険パターンを再チェックしたあと、「評価の時点では安全と確認できていたのに、再チェックで未確認に転じた項目」だけを対象にします。その項目だけ、評価役へ一回だけ「この危険クラスは本当に安全か、根拠を添えて答えよ」と問い合わせます。効かせている条件がいくつもあります。
- 対象は「新たに未確認に転じた項目」だけ。評価時点からずっと未解消の危険は clear させない(安全の下限は緩めない)
- 応答が空、「安全でない」、根拠のない承認は、すべて据え置き(人間へ差し戻し)
- 検証が実行できなかった項目(フェイルクローズド扱い)は承認の対象から外す
- 反復ループは作らない。問い合わせは一回きり
恒久 allowlist との違いはここです。allowlist は「パターン」に永続免罪符を与えますが、one-shot clearance は「この一回のこの変更」にしか効きません。次に同じパターンが出れば、また同じ検証を通ります。判断の重さと自動化のバランスを、パターン単位ではなく変更単位に置き直した形です。
2. LLM の自由文を制御入力にしない:ブランチ名の検証
次はもっと地味ですが、事故の入口になりやすい箇所です。パイプラインはどのブランチをマージ先(base)にするかを、しばしば LLM 経由で受け取ります。ユーザー指示や issue の文面から決まる値を、リモートの参照を調べる git ls-remote のコマンドに埋め込みます。
落とし穴が二つありました。一つは、ブランチの存在確認を末尾一致でやっていたこと。feature/dev のようなブランチが dev に誤ってヒットし、意図しないマージ先が選ばれかねませんでした。対策は、参照パスを refs/heads/ 前置の完全一致に変えることです。
もう一つが本題で、LLM 由来の文字列を検証せずコマンドに埋め込んでいたことです。$(...) やバッククォートは git の参照名として合法な文字を含みうるので、無検証だと probe コマンドに紛れ込みます。ここで効かせたのが allowlist 方式の検証で、base 引数の正規化関数に次の許可パターンをかませます。
const BASE_ARG_ALLOWLIST = /^[A-Za-z0-9][A-Za-z0-9._/-]*$/;

function normalizeBaseArg(raw) {
  if (raw == null) return null;
  if (typeof raw !== 'string') {
    throw new Error('base は非空文字列で指定せよ');
  }
  const trimmed = raw.trim();
  if (trimmed === '') return null;
  if (!BASE_ARG_ALLOWLIST.test(trimmed)) {
    throw new Error('base に使用できない文字が含まれる');
  }
  return trimmed;
}
考え方は「拒否リストで危ない文字を数え上げる」のではなく「安全と分かっている文字だけ許す」です。英数字とごく一部の記号だけを通し、それ以外は入り口で弾きます。禁止パターン列挙は抜けが出ますが、許可パターン方式なら想定外はすべて既定で不許可になります。
もう一つ大事なのは、base ブランチの解決そのものを決定論的な純関数に切り出したことです。優先順位は「明示指定があれば存在を検証してから使う、なければ origin/dev、それも無ければ origin/HEAD の既定ブランチ」です。リモートを叩くだけの probe と、その結果から答えを組み立てる関数に分けました。LLM が返した文字列は「候補」でしかなく、採否はこの関数が決めます。これが記事全体の原則です——LLM の自由文出力は、検証と決定論的な解決を通してからでないと制御入力にしない。
3. breaking 変更の検出を、正しい入力に限定する
マージ層でもう一つ人間を必ず挟みたいのが、破壊的変更(breaking / migration を伴う変更)です。ここで長らく使っていた入力が、実はよくない場所でした。
以前は、LLM が書いたコミットの scope や要約テキストに正規表現をかけて breaking を判定していました。LLM の自由文出力を、マージの合否という重い判断の入力にしていたわけです。自由文は同じ意図でも毎回言い回しがブレるので、拾えたり漏れたりします。検出のはずが実際はギャンブルでした(同じ変更を二回流して片方だけ止まる門番は困ります)。「同じ入力なら同じ判定が返る」という当たり前の性質を、自由文ベースでは満たせませんでした。
これを二つの入力の OR に切り替えました。一つは、要件を分析するステップが返す構造化された breaking_change フィールド(スキーマで真偽値として型が保証される)。もう一つは、issue のタイトルと本文に対する決定論的なキーワードスキャン(人間が書いた一次情報で言い回しがブレない)。どちらかが立てば、規模の下限を最も慎重な段階(complex)に引き上げます。
if (req.breaking_change === true || req.breaking_keyword_scan === true) {
  const srcs = [];
  if (req.breaking_change === true) srcs.push('構造化フィールド');
  if (req.breaking_keyword_scan === true) srcs.push('issue 本文スキャン');
  // どちらの入力で立ったかを理由に残す → 後で監査できる
  floor = 'complex';
}
細かいですが、「どの入力で breaking と判定されたか」を理由として残しているのも効きます。あとで「なぜ人間送りになったのか」を追えるからです。判定を決定論にすると理由も決定論的に記録できる、という副産物があります。
ちなみに、この「規模の下限」には LLM も関与しますが、動ける方向が制限されています。見積もりを引き上げる方向にしか効かせられず、コードが決めた下限より下には動かせません。慎重側にしか倒せない設計です(楽観的な過小評価はできない)。
4. 依存インストールを lockfile のあるときだけに限定する
最後は supply-chain に近い話です。エージェントは変更ごとに隔離された作業ツリー(git worktree)を作り、依存をインストールしてテストを回します。無条件でやると二つ困ります。
一つは非決定性です。lockfile が無いエコシステム(package.json だけ置いてある等)だと事故ります。npm install で新しい lockfile が生成され、依存が勝手に解決されます。結果として、変更差分にセットアップ処理が作ったノイズが混ざります。自分の作業を自分で汚しにいく格好です(掃除する前に土足で入ってくる同居人のような)。差分が汚れると変更規模の判定まで狂います。
もう一つが信用の問題です。lockfile が無い状態でのインストールは、その時点の最新版をネットワークから引いてくることを意味し、何が入るかを固定できません。
対策はシンプルで、依存インストールを lockfile があるときだけ に絞りました。セットアップが呼ぶスクリプトに lockfile-only のフラグを足します。lockfile を持つエコシステムでは npm ci のように固定されたバージョンだけを入れ、lockfile が無ければインストール自体を no-op でスキップします。エージェントに渡す指示にも一文入れています——必要なら worktree 直下で自分でインストールしてよいが、lockfile は書き換えるな。
固定されたものだけを固定されたまま入れる。勝手に解決させない。AIに任せる範囲が広がるほど「入力を固定する」判断が効きます。
貫いているのは一つの線引き
4つの門番を並べましたが、やっていることは全部同じ形です。
| 門番 | LLM に任せないこと | 決定論で決めること |
|---|---|---|
| 危険検出 | 危険かどうかの最終判定 | パターン検出と承認条件 |
| base 解決 | ブランチ名をそのまま信用 | allowlist 検証と優先順位 |
| breaking 検出 | 自由文からの拾い上げ | 構造化フィールド + issue スキャン |
| 依存インストール | 何を入れるかの裁量 | lockfile があるものだけ |
LLM は優秀な提案者ですが、提案をそのままゲートの合否に使うと出力のブレが門の緩さになります。提案は「候補」として受け取り、通すかどうかは小さな純関数が決める。その関数は慎重側にしか倒れないように作ります(危険なら止める、判断できなければ止める、安全と実証できたときだけ通す)。
この設計のいいところは、門番を一つずつ足したり調整したりできることです。最初から完璧な自動マージを目指す必要はありません。「まずは危険検出だけ人間送り」から始めて、運用しながら one-shot clearance や lockfile 制限を継ぎ足していけます。AIにどこまで任せるかの線は、門番の数と厳しさで少しずつ動かせる可変のダイヤルだと考えるのが実際的です。
まとめ
AIが作った PR を自動マージするかは「全自動か全レビューか」の二択ではありません。危険な変更だけを機械的に拾い、そこだけ一回限りの承認で人間を挟む。ブランチ名のような LLM 経由の入力は allowlist と完全一致で検証する。breaking の判定は自由文ではなく構造化フィールドと issue 本文に置く。依存は lockfile のあるものだけ入れる。
共通しているのは、合否は決定論的な関数が決め、LLM の出力は検証してから使うという一点です。この線引きさえ守れば、AIに任せる範囲は安全に少しずつ広げられます。門番は多いほど偉いのではなく、止めるべきものだけを確実に止められることが偉い。そこを外さなければ自動マージは十分に現実的です。